hogashi.*

日記から何から

■

blog.sushi.money

 ↑この記事でアンソロジーを書いてもらったらこうなった。
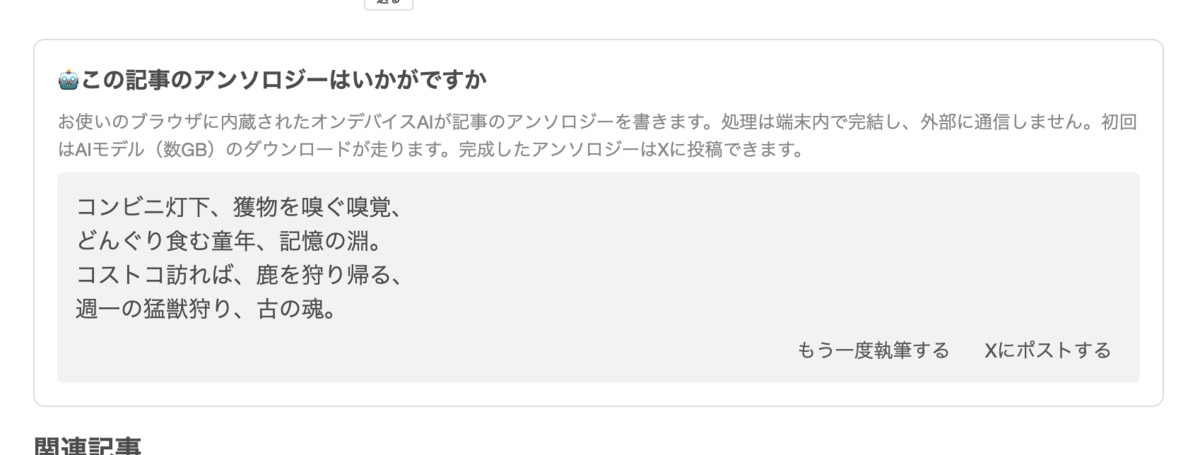
コンビニ灯下、獲物を嗅ぐ嗅覚、
どんぐり食む童年、記憶の淵。
コストコ訪れば、鹿を狩り帰る、
週一の猛獣狩り、古の魂。

 漢詩っぽかったので Gemini に漢詩にしてもらった。

\begin{array}{l}
\text{夜}\text{店}\text{燈}\text{前}\text{嗅}_{\text{二}}^{\text{ギ}}\text{獵}\text{禽}_{\text{一}}^{\text{ヲ}} \\
\text{童}\text{年}\text{食}_{\text{レ}}^{\text{ミテ}}\text{橡}^{\text{ヲ}}\text{憶}_{\text{二}}^{\text{フ}}\text{幽}\text{深}_{\text{一}}^{\text{ヲ}} \\
\text{巨}\text{庫}\text{尋}^{\text{ネ}}\text{來}^{\text{リテ}}\text{鹿}\text{肉}^{\text{ヲ}}\text{擒}^{\text{フ}} \\
\text{七}\text{日}\text{一}\text{征}\text{醒}_{\text{二}}^{\text{マス}}\text{古}\text{心}_{\text{一}}^{\text{ヲ}}
\end{array}

【白文】
夜店燈前嗅獵禽
童年食橡憶幽深
巨庫尋來鹿肉擒
七日一征醒古心

【書き下し文】
夜店(やてん) 燈前(とうぜん) 猟禽(りょうきん)を嗅ぎ、
童年(どうねん) 橡(どんぐり)を食(は)みて 幽深(ゆうしん)を憶(おも)ふ。
巨庫(きょこ) 尋(たず)ね来たりて 鹿肉(しかにく)を擒(とら)え、
七日(なぬか)の一征(いっせい) 古心(こしん)を醒(さ)ます。

 再翻訳してもそれらしく解釈されていてすごい。しかし元の記事から考えると漢詩のためにだいぶ肉付けされている感もある。

この漢詩の現代語訳をつくるとどうなる?
夜店燈前嗅獵禽
童年食橡憶幽深
巨庫尋來鹿肉擒
七日一征醒古心

ご提示いただいた漢詩は、現代の日常(おそらく週末の大型スーパーやコストコのような倉庫店への買い物)を、古代の「狩猟」に見立てて詠んだ非常にユーモアのある創作漢詩とお見受けします。

以下に書き下し文と現代語訳、そして簡単な解説をまとめました。

書き下し文(読み方)

夜店(やてん)の燈前(とうぜん) 猟禽(りょうきん)を嗅(か)ぐ
童年(どうねん) 橡(どんぐり)を食(く)らい 幽深(ゆうしん)を憶(おも)う
巨庫(きょこ)に尋(たづ)ね来(きた)りて 鹿肉(ろくにく)を擒(とら)う
七日(なのか)に一(ひと)たび征(ゆ)き 古心(こしん)を醒(さ)ます

現代語訳

夜の店先の明かりに照らされながら、獲物の鳥(ローストチキンや惣菜の焼き鳥など)の香ばしい匂いを嗅ぐ。
子供の頃に木の実(どんぐり)を拾って食べた、あの奥深い森の情景が脳裏に蘇る。
巨大な倉庫(大型スーパーやコストコなどのメガストア)に足を踏み入れ、お目当ての鹿肉(特売の肉やジビエ)を仕留める。
七日に一度(週末ごと)のこの遠征が、私の中に眠る古(いにしえ)の狩猟本能を呼び覚ますのだ。

鑑賞と解説
  • 夜店・巨庫:現代の夜のスーパーや「巨大な倉庫店」を指していると思われます。現代の買い物を壮大なスケールで表現しています。
  • 猟禽・鹿肉:実際にはパック詰めされた鶏肉やジビエ肉(あるいは牛肉などの比喩)を「獲物」として捉え、買い物を「狩り」に見立てるセンスが光ります。
  • 七日一征:「週に一度のまとめ買い」を「七日ごとの討伐・遠征」と大げさに表現しており、ここがこの詩の最大のオチ(古心の覚醒=狩猟採集民の血が騒ぐ)に繋がっています。

現代の生活感と漢詩特有の重厚な語彙のギャップがとても面白い作品です。
■

 AI を駆使して仕事していると、色々な新しいジャンルの疲れがあるのだが、それらとは別に、思い悩む時間が増えたことによる疲れもあるなとふと気付いた。
 自分で色んなことをやっていた頃は、ある程度作戦を練る時間と、ある程度作業を進めてみる時間があり、分かっていることはするする進み、悩ましいことに当たって悩み、という暮らしだった、多分。それが、分かっていることは高速に進められるグッズを得たせいで、作戦や判断に悩んだりする事柄が押し寄せており、総じて悩む時間が増えている。

 あと別の話題として、分かっていることを認識する時間が減り、分かっていること自体を軽視しがちになっていて、自分の技量を正しく自分の自信にすることができていない。その結果、こんなんでいいのか、と思い悩む時間も増えている。

tmux 3.8でマウス操作がデフォルトONになっている

 tmux 3.8 でマウス操作がデフォルト ON になっていた。 release note として issue に書かれている通り、 set -g mouse off で OFF に戻せる。

github.com

  • Mouse support is now enabled by default; it can be turned off again with set -g mouse off.
3.8 questions and comments · Issue #5584 · tmux/tmux · GitHub

 普段マウス操作でめちゃくちゃにならないように、できるだけキーボード操作を使っているので、 OFF に戻しておいた。特にどこで議論されているわけでもなく、デフォルト値が変わったよ、というだけのことっぽい。

 Claude に調べてもらうと、マウス操作系の機能がいくつか入ったから、という推測ができるらしい。

同じ時期に、マウス操作が前提の機能がまとめて入っています。

  • フローティングペイン(境界のドラッグで移動・リサイズ、Ctrl+ドラッグで新規作成)
  • メニュー
  • ペインのステータス行のマウス操作
  • 新しいテーマ

3.8 の UI 刷新に合わせて、こうした機能を最初から使えるようにするために ON にした、と考えるのが自然です。ただし、これは私の推測です。

■

blog.3qe.us


 世間の言説はさておきとにかく自分は大切なものであるというのが良かった。そう信じていくしかないなと度々思う。凹むと生きる意味とかを考えるし、しかしそこに明確な答えはなく、論理的に根拠を持って生きることができないため、無条件に生きることは良いと (定理ではなく公理として) 持つしかないなと思っている。

 AI の席巻によって気分が滅しているのも共感しつつ、自分のできることを AI が颯爽とやっていくことに無力を感じる一方で、よく見ると品質がまだまだであることにも幻滅する日々を送っている。まあしかしこれは時間の問題ではあると思う。たとえば最近のプラ製品にはバリが残りまくっていて指を怪我することが多いが、昔はそんなことなかったな (実際なかったり、実はあったりしただろうけど、そう記憶しているということ) と思う。でも安価に高速に生産するには、いちいち手で持つ場所のバリを取ることができないんだろう、十分安いし許す、というような、許すというよりは諦めるような感覚がある。これがゆくゆく AI に対しても起きるだろうと思って、品質が8割程度でも、量がすさまじいことによって人々がなあなあで許容していくのだろうという、残念さや寂しさを感じる。これが最近は最も自分を幻滅させている。

 またそういう劇的な過渡期にある AI を、それでもうまく使えることが求められており、しかし AI は機械で道具であるから、うまく使えなかったら自分の使い方が悪いと評価される。この、うまく使えていない自分のせいという、いわゆる自分を映す鏡のように AI が振る舞っているのが、自分をなんとも歪んで映して悲しくなる。本当は色々心配したり考えたりできているはずなのに、それらが抜け落ちた品質 6割の出力をされて、それが自分であると暗に諭されてしまう。そんなものを見ながら、そうではないはずだとレビューして直すのが務めだとなると、これもまた必死に取り繕うように感じられて、しゃんと立てていない。自分なら最初からもっと良いものを書けるのに、とだけ言うが、もちろん AI よりもずっと時間がかかるので、それをやりきる自信もあまりない。こんだけ時間かかってこれ? AI ならもっとすぐいいの出してくるよ、と言われることを (誰からとなく) 恐れているから。

 こういったイメージは自分が勝手に持っているもので、少なくとも今いる職場では周りからそんな変な評価はされないし、 AI は自分を映しているわけではない (少なくともモデルは自分を元にしていない)。だから、一定の価値のあることを自分ができると信じることや、世間と一括りにするのをやめて周りの個々人をよく見てそれぞれを信じて大事にすることなど、自分の打ちひしがれて以来の認識を少し冷静に是正していく必要がある時期なのだ、と思うようにしている。かつて計算機に対して想像もしなかったことが起きているので、つまり今もどこかで想像もしないことが起きまくっているのでは? その中のひとつとして、自分の考えが及ばないところで自分の価値は落ちているのでは? と思いそうになるが、 (相対的にどう評価されるかはさておき) 自分の絶対的な人生というものは、生きていれば依然そこにある。 10進数を使っていると桁が増えて驚くが数直線の上ではただ 1 の差であることに変わりがないというような、世紀末というと驚くが地球の自転公転に区切りは特にないというような、絶対的な振る舞いは常に価値があると信じたい。

 AI がうまくやっても下手をやっても、自分は自分であって、かわりに凹んでやる義理はない。うまく使えたら嬉しいね、というような考え方で十分かなと思い始めている (まだ染み付いた恐怖は拭いきれていないが……)。

 あと、速さを求めてある程度の品質でけりをつける仕事などでない、自分の趣味であれば、 AI ができることでも、誰ができることでも、自分がやって楽しいことをやっていいというのは別に覚えておきたい。プロサッカー選手のほうがサッカーはうまいが、誰でもサッカーをしてもいい。楽しむことが目的であるから。

fzfでC-rを他のオレオレ関数にしたいときFZF_CTRL_R_COMMAND環境変数を空文字にするとよい

三行

  • fzf をセットアップすると自然と Ctrl-R (C-r) が fzf を使った history 検索になる
  • これを無効にするには、環境変数 FZF_CTRL_R_COMMAND を空文字にしたらよい
    • Ctrl-R は元の reverse-search-history に戻したいとか、 peco でオレオレ関数を作って使いたい場合など

詳細

 fzf の README に書いてある。 fzf の README には他にもカスタマイズ含めた色々な知識が書かれていて超大作なので読むと楽しい。

  • CTRL-R - Paste the selected command from history onto the command-line.
    • (snip)
    • Can be disabled by setting FZF_CTRL_R_COMMAND to an empty string when sourcing the script
https://github.com/junegunn/fzf/blob/master/README.md#key-bindings-for-command-line

AIのぽんこつがなぜなのかを少し理解した / 仕組みが好き

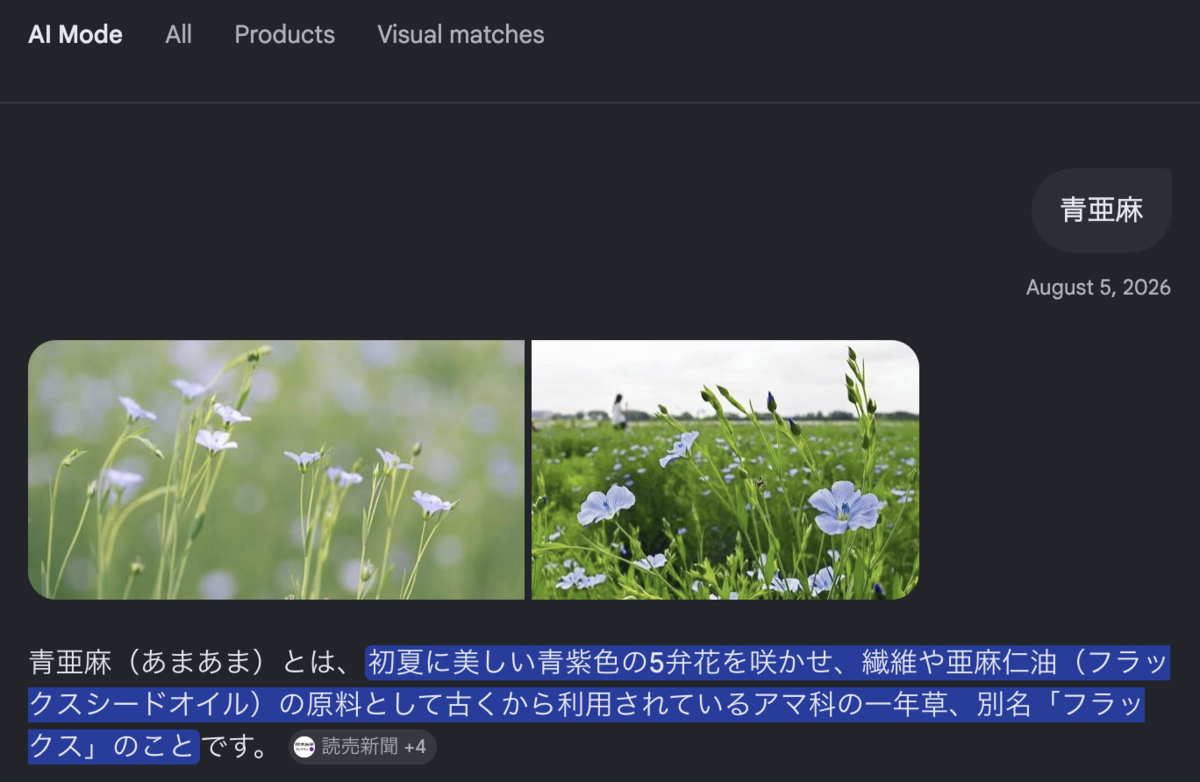
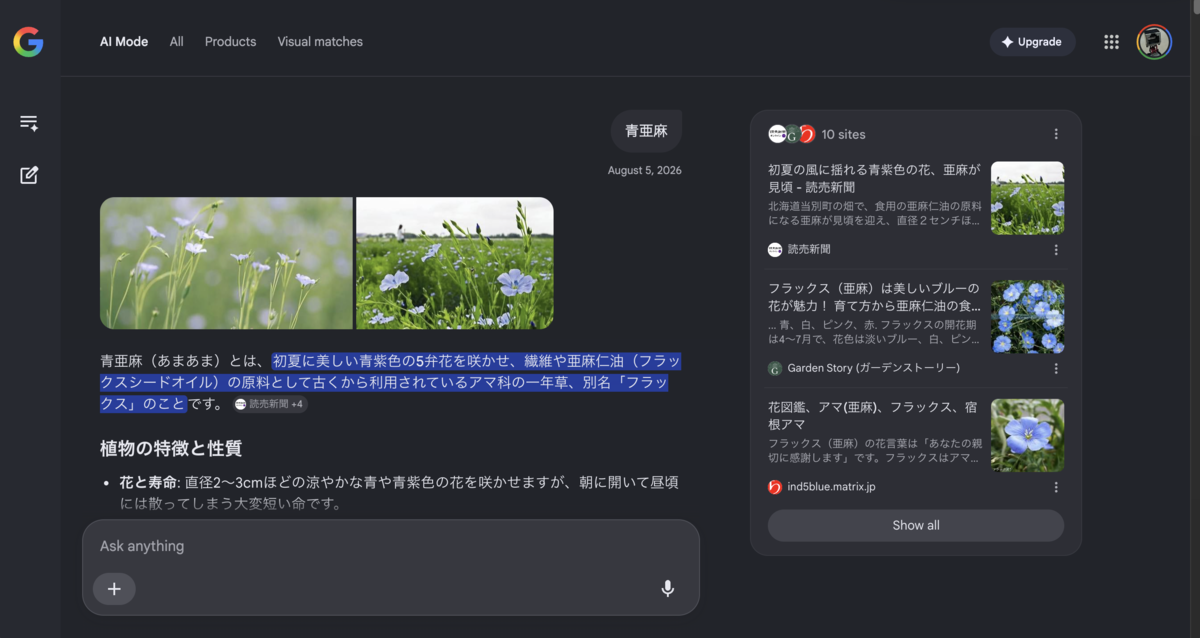
 Google 検索で「青亜麻」を検索したところ、 Google 検索に据え付けの Gemini が、読みを「あまあま」として解説し始めた。


 流石に違うんじゃないかと思って、あってる? と聞くと、間違いでした、と言う。なぜ聞くとわかることが一発目に間違ったまま出てくるのか気になって、そのまま技術的に解説してもらった。

hogashi-generated.hateblo.jp

 ざっくりとした理解しかできてないものの、

  • 今の LLM の基本のつくりが文章を形態素解析のように区切ってトークン化して扱うものである
  • 出力するときに、次の文字 (トークン) を作り出すにあたっては、局所的に推測するものである
    • 文章全体を常に見ながら (推敲しながら) 出力するわけではない
  • 知らない単語に遭遇したときには、持ちうる知識のすべての関連度がほぼ 0 になる
    • 相対的に直前の単語が関連知識として使われがち
  • 日本語には「熱々」のような繰り返しの言葉 (畳語というらしい) が存在する

…ということの組み合わせで、間違って繰り返したまま出力してしまった事例らしい (詳細な説明は 2511.12869 On the Fundamental Limits of LLMs at Scale にある)。

 これだけ分かっていながら、なんとかしてないのか? と聞くと、最近の研究ではやってます、とのこと。

  • 出力としてユーザに見せる前に一回推敲する (reasoning*1 というらしい)
    • これは対症療法的だけど、全体を見なかったのが見るようになるので、精度はあがる
    • Gemini とか Claude とかの思考モードみたいなのがそれっぽい?
  • トークン化をしない (ByT5*2 というやつなど)
    • UTF-8 のバイト列とか、画像とかとして扱うことで、知っている/知らない単語という区別をなくす
    • 論文をサラ読みすると、言語が混ざった文などで強みがあるとか書いてある
      • "フランス語のこの単語は日本語ではこう書く"という英語の文章、とか。フランス語英語日本語が混ざっているけど、全部 UTF-8 で解釈すればトークン化の難しさはない
  • 関連度の計算を線形にやる (Mamba*3 というやつなど)
    • 従来の方法では、持っている知識との関連度を計算するとき、すべての知識の関連度が 0 で、直前の単語の関連度が 0.1 とかだと、 ソフトマックス関数 - Wikipedia というので計算すると、直前の単語のほうをほぼ 100% として引き上げてしまう (Softmax というのが実数たちを割合にして合計で 1 にする関数のため) *4
      • これは Softmax が非線形な計算をしていて、実際は関連度そうでもないのに 100% という見え方になるのがよくない
    • 代わりに、知識の関連度の計算を線形にやると、どの知識も、直前の単語も、それなりに低い確率であるという見え方になる
    • これをやるために、知識の記録をするときも、入力に応じた重み付けの行列を掛け算するとのこと (Selective State Space Model というらしい)

 大分ふんわりした理解だけど、これまで全くわかってなかった状態に比べると、ある程度は仕組みを理解することができて、ぽんこつ出力を見ても、そういうこともあるよね、と思える度が上がった。

 こういう、日々のできごとを元にその仕組みを知る、という活動が好きだったな、と思い出せる良い回だった。勉強しようと身構えるとなかなか難しいが、これは何がどう動いてそうなっているのか? とか考えながら引き続き暮らしていきたい。

bashでgit worktreeを使うとき不便なのでpecoでpushdするコマンドつくったりPS1いじったりした

 git worktree list は素朴すぎてむずいので peco で pushd できるようにした。先駆者はたくさんいるが、僕も前に ghq list でやったことがあったのでそれをコピペして使っている。
 コミットハッシュとかブランチ名とかも出るけど、あったほうが当然わかりやすいので出す。絞り込むときはブランチ名でやるだろうし……。

function gw() {
  ARG_STR="$@"
  PECO_RESULT=$(git worktree list | peco --query "$ARG_STR")

  PECO_RESULT=$(echo -n "${PECO_RESULT}" | awk '{ print $1 }' | tr -d '\n' | perl -pe 's/(^ | $)//g')
  if [ ! -n "$PECO_RESULT" ]; then
    return 1
  fi

  if [ -d "$PECO_RESULT" ]; then
    pushd "$PECO_RESULT"
  fi
}
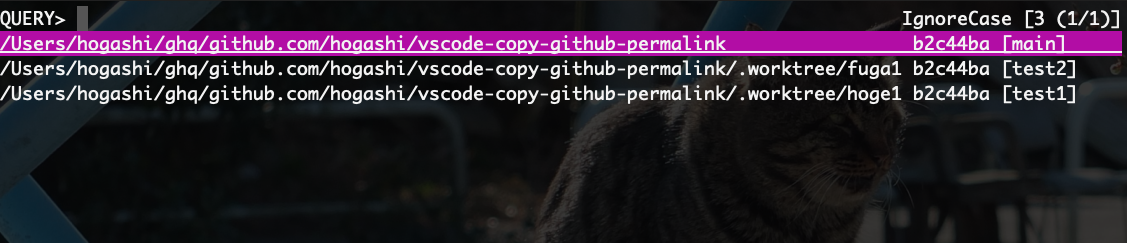
git worktree list が peco で選択できる様子

 PS1 は元々 __git_ps1 を使っていたのを、遅いなとか言って .git/HEAD を見るように変えてあった (なので upstream との差分とかの記号のアレは出してない)。
 これだと worktree では動かない (.git が単にファイルで gitdir: ... とか書いてあるだけなため) 。なので worktree なときには諦めて __git_ps1 をフォールバックとして呼ぶことにした。

- GITPS1='$(echo -n " $([ -f "$(pwd)/.git/HEAD" ] && cat $(pwd)/.git/HEAD | cut -d" " -f2 | tr -d "\n") " | perl -pe "s|refs/heads/||")'
+ GITPS1='$(echo -n " $([ -f "$(pwd)/.git/HEAD" ] && (cat $(pwd)/.git/HEAD | cut -d" " -f2 | tr -d "\n") || ([ -f "$(pwd)"/.git ] && __git_ps1)) " | perl -pe "s|refs/heads/||")'
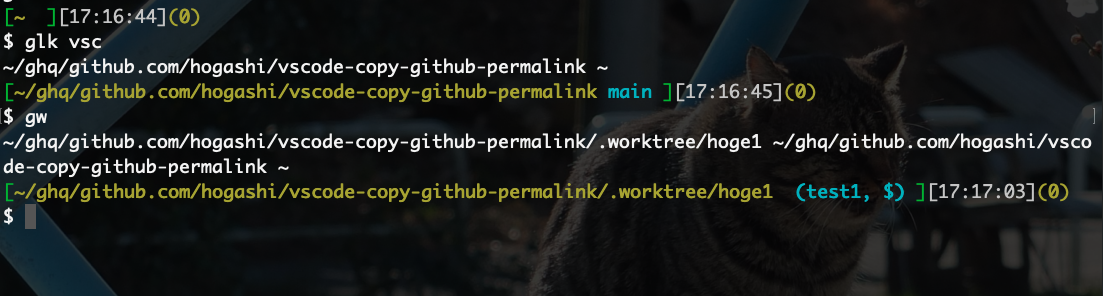
worktree 内では __git_ps1 が呼ばれている様子