Google 検索で「青亜麻」を検索したところ、 Google 検索に据え付けの Gemini が、読みを「あまあま」として解説し始めた。
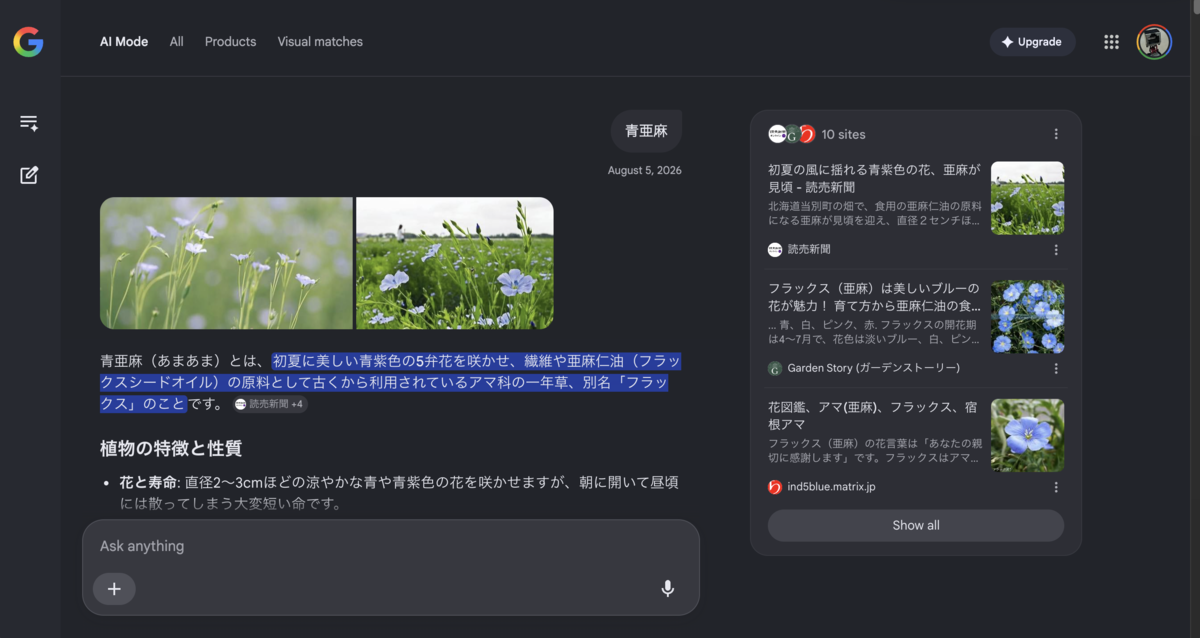
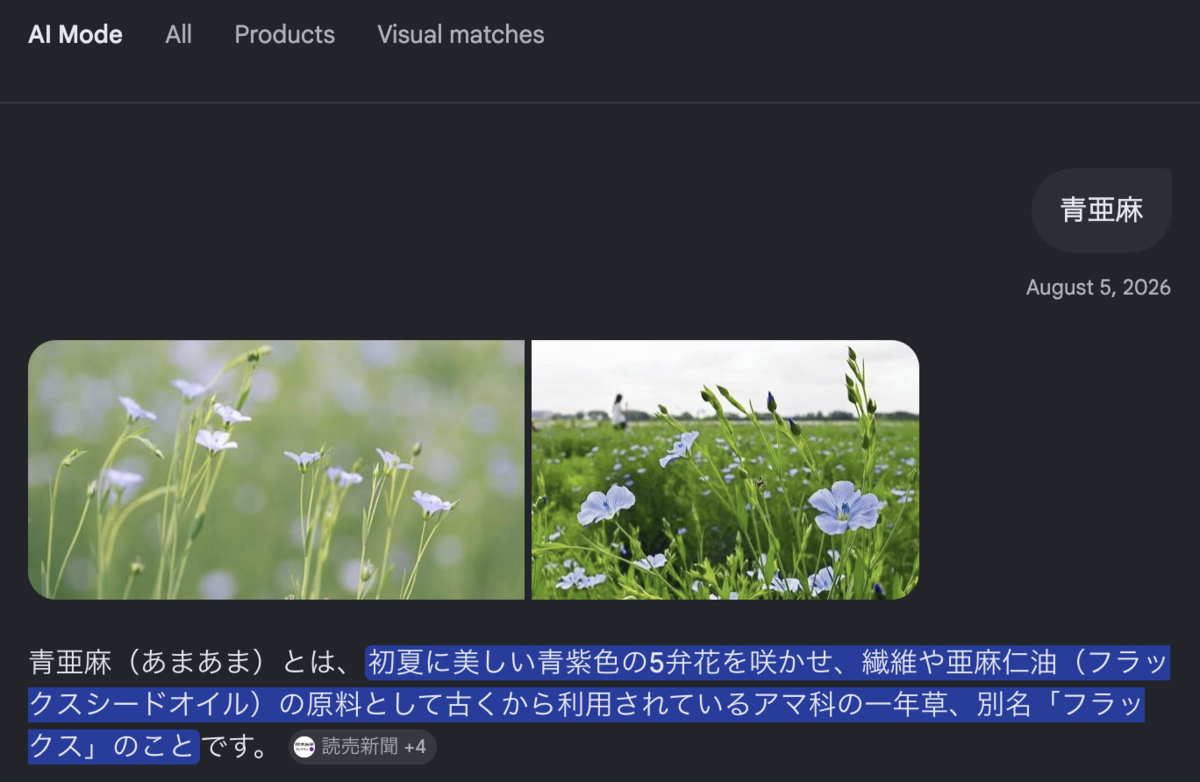
流石に違うんじゃないかと思って、あってる? と聞くと、間違いでした、と言う。なぜ聞くとわかることが一発目に間違ったまま出てくるのか気になって、そのまま技術的に解説してもらった。
ざっくりとした理解しかできてないものの、
- 今の LLM の基本のつくりが文章を形態素解析のように区切ってトークン化して扱うものである
- 出力するときに、次の文字 (トークン) を作り出すにあたっては、局所的に推測するものである
- 文章全体を常に見ながら (推敲しながら) 出力するわけではない
- 知らない単語に遭遇したときには、持ちうる知識のすべての関連度がほぼ 0 になる
- 相対的に直前の単語が関連知識として使われがち
- 日本語には「熱々」のような繰り返しの言葉 (畳語というらしい) が存在する
…ということの組み合わせで、間違って繰り返したまま出力してしまった事例らしい (詳細な説明は 2511.12869 On the Fundamental Limits of LLMs at Scale にある)。
これだけ分かっていながら、なんとかしてないのか? と聞くと、最近の研究ではやってます、とのこと。
- 出力としてユーザに見せる前に一回推敲する (reasoning*1 というらしい)
- これは対症療法的だけど、全体を見なかったのが見るようになるので、精度はあがる
- Gemini とか Claude とかの思考モードみたいなのがそれっぽい?
- トークン化をしない (ByT5*2 というやつなど)
- UTF-8 のバイト列とか、画像とかとして扱うことで、知っている/知らない単語という区別をなくす
- 論文をサラ読みすると、言語が混ざった文などで強みがあるとか書いてある
- "フランス語のこの単語は日本語ではこう書く"という英語の文章、とか。フランス語英語日本語が混ざっているけど、全部 UTF-8 で解釈すればトークン化の難しさはない
- 関連度の計算を線形にやる (Mamba*3 というやつなど)
- 従来の方法では、持っている知識との関連度を計算するとき、すべての知識の関連度が 0 で、直前の単語の関連度が 0.1 とかだと、 ソフトマックス関数 - Wikipedia というので計算すると、直前の単語のほうをほぼ 100% として引き上げてしまう (Softmax というのが実数たちを割合にして合計で 1 にする関数のため) *4
- これは Softmax が非線形な計算をしていて、実際は関連度そうでもないのに 100% という見え方になるのがよくない
- 代わりに、知識の関連度の計算を線形にやると、どの知識も、直前の単語も、それなりに低い確率であるという見え方になる
- これをやるために、知識の記録をするときも、入力に応じた重み付けの行列を掛け算するとのこと (Selective State Space Model というらしい)
- 従来の方法では、持っている知識との関連度を計算するとき、すべての知識の関連度が 0 で、直前の単語の関連度が 0.1 とかだと、 ソフトマックス関数 - Wikipedia というので計算すると、直前の単語のほうをほぼ 100% として引き上げてしまう (Softmax というのが実数たちを割合にして合計で 1 にする関数のため) *4
大分ふんわりした理解だけど、これまで全くわかってなかった状態に比べると、ある程度は仕組みを理解することができて、ぽんこつ出力を見ても、そういうこともあるよね、と思える度が上がった。
こういう、日々のできごとを元にその仕組みを知る、という活動が好きだったな、と思い出せる良い回だった。勉強しようと身構えるとなかなか難しいが、これは何がどう動いてそうなっているのか? とか考えながら引き続き暮らしていきたい。
